Content clustering voor maximale LLM-herkenning: zo wordt uw merk de bron die AI kiest
AI-engines zoals ChatGPT, Perplexity en Google AI Overviews citeren niet zomaar willekeurige pagina's. Ze zoeken naar websites die een onderwerp breed en diep behandelen. Zonder een duidelijke contentstructuur mist uw merk de aansluiting bij de manier waarop large language models (LLM's) informatie selecteren en presenteren. Content clustering is de methode waarmee u uw website omvormt tot een autoriteitsbron die AI niet kan negeren.
In deze tutorial leert u stap voor stap hoe u content clusters opbouwt die specifiek zijn ontworpen voor maximale LLM-herkenning.
Waarom content clustering essentieel is voor AI-zichtbaarheid
Traditionele SEO draaide om losse pagina's die elk op één zoekwoord rankten. LLM's werken fundamenteel anders. Ze beoordelen de samenhang tussen pagina's om te bepalen of een website werkelijk expertise bezit over een onderwerp.
Een enkel blogartikel over "GEO" overtuigt geen AI-model. Maar een cluster van onderling verbonden pagina's over generative engine optimization, technische implementatie, en meetbare resultaten wel. Dat patroon signaleert topicale autoriteit.
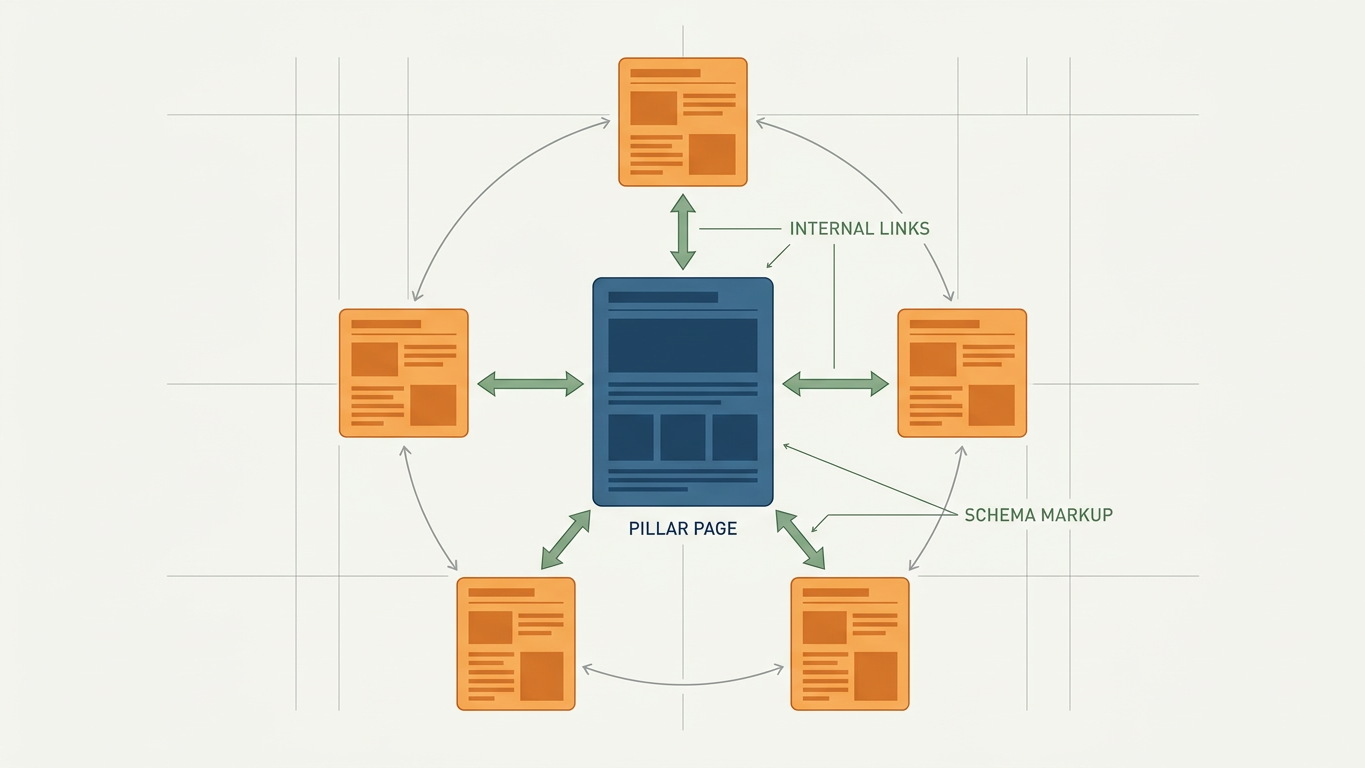
Content clustering groepeert uw content rond kernonderwerpen. Elke cluster bestaat uit een pillar page (de hoofdpagina) en meerdere ondersteunende artikelen die deelonderwerpen uitdiepen. De onderlinge links vormen een web van context dat LLM's helpt om uw merk als primaire bron te selecteren.
Stap 1: bepaal uw kernonderwerpen vanuit AI-queries
Begin niet bij zoekwoorden, maar bij de vragen die gebruikers aan AI stellen. Dit is een fundamentele verschuiving. AI-queries zijn conversationeel en vaak breder dan traditionele zoekopdrachten.
Zo brengt u uw kernonderwerpen in kaart:
- Identificeer de drie tot vijf thema's waarover uw organisatie de meeste expertise heeft.
- Formuleer per thema minimaal tien vragen die een gebruiker aan ChatGPT of Perplexity zou stellen.
- Groepeer die vragen rond deelonderwerpen die samen het volledige thema afdekken.
Een GEO-audit laat direct zien op welke queries AI u al noemt en waar de gaten vallen. Die gaten zijn uw kansen voor nieuwe clustercontent.
Stap 2: ontwerp de clusterstructuur
Elk cluster volgt een vaste architectuur. De pillar page behandelt het kernonderwerp breed. De ondersteunende pagina's gaan diep op specifieke deelvragen in.
| Element | Functie | Voorbeeld |
|---|---|---|
| Pillar page | Breed overzicht van het kernonderwerp | "Wat is GEO?" |
| Clusterpagina | Diepgang op één deelvraag | "Wat is llms.txt?" |
| Interne link | Verbindt cluster en bevestigt samenhang | Link van pillar naar clusterpagina en vice versa |
| Schema markup | Vertaalt structuur naar machineleesbare taal | FAQ-schema, Article-schema |
De pillar page linkt naar elke clusterpagina. Elke clusterpagina linkt terug naar de pillar. Dit creëert een gesloten informatienetwerk dat LLM's als coherente kennisbron herkennen.
Praktijkvoorbeeld: een cluster rond llms.txt
Stel, u wilt autoriteit opbouwen rond het onderwerp llms.txt. Uw cluster ziet er dan als volgt uit:
- Pillar page: Alles over llms.txt en AI-crawlers
- Clusterpagina 1: Hoe u een llms.txt-bestand aanmaakt
- Clusterpagina 2: Het verschil tussen robots.txt en llms.txt
- Clusterpagina 3: Welke AI-crawlers llms.txt ondersteunen
- Clusterpagina 4: Veelgemaakte fouten bij llms.txt-implementatie
Elke pagina beantwoordt een specifieke vraag die een AI-engine kan ontvangen. Samen vormen ze het bewijs dat uw website het onderwerp volledig beheerst.
Stap 3: optimaliseer elke pagina voor citeerbaarheid
LLM's zoeken naar tekst die ze direct kunnen overnemen als antwoord.
Maak elke pagina citeerbaar met deze principes:
- Begin elke paragraaf met de conclusie. AI-engines scannen de eerste zin van een alinea als potentieel citaat.
- Gebruik definities en directe antwoorden. Formuleer zinnen als: "Content clustering is de methode waarbij..." in plaats van vage inleidingen.
- Voeg gestructureerde data toe. Schema markup vertaalt uw tekst naar een taal die AI begrijpt. Denk aan FAQ-schema, HowTo-schema en Article-schema.
- Houd alinea's kort. Maximaal drie tot vier zinnen per alinea verhoogt de kans dat een LLM een coherent fragment selecteert.
Stap 4: meet en verbeter uw clusterprestaties
AI-antwoorden zijn een zero-sum game. Als uw concurrent de bron is, bent u dat niet.
Content clustering is geen eenmalige actie. Het is een continu proces van meten, bijsturen en uitbreiden. De vraag is niet alleen of AI u noemt, maar ook hoe en in welke context.
Met een GEO Readiness Score meet u per pagina hoe goed uw content scoort op de criteria die LLM's hanteren. De score van 0 tot 100 geeft u een helder startpunt. Door kwartaalrapportages bij te houden via trendtracking, ziet u exact welke clusters aan kracht winnen en welke bijsturing nodig hebben.
Controleer per kwartaal de volgende punten:
- Op welke queries wordt uw pillar page geciteerd door ChatGPT, Perplexity, Google AI Overviews en Claude?
- Welke clusterpagina's worden het vaakst als bron geselecteerd?
- Waar noemen AI-engines uw concurrent in plaats van u?
Begin vandaag met uw eerste content cluster
Content clustering voor LLM-herkenning vraagt om een methodische aanpak: kernonderwerpen definiëren, een heldere clusterstructuur bouwen, pagina's citeerbaar maken en continu meten. Het verschil tussen gevonden worden door AI en onzichtbaar blijven zit in die structuur.
Wilt u weten hoe AI-engines uw huidige content beoordelen? Start uw audit en ontvang binnen enkele minuten uw GEO Score met direct toepasbare aanbevelingen. Geen account nodig, geen setup, geen API-keys.
Heeft u vragen over uw GEO-strategie? Neem contact op en ontdek hoe u uw content clusters naar het volgende niveau tilt.