Canonical tags en AI-crawlers: wat u móét weten als technisch lead
Waarom canonical tags nu ook voor AI-crawlers essentieel zijn
Canonical tags bepalen nu óók welke paginaversie AI-engines als bronmateriaal gebruiken.
Canonical tags zijn geen nieuw concept. Maar hun functie verandert fundamenteel nu AI-crawlers van OpenAI, Anthropic en Google uw site indexeren. Waar canonical tags traditioneel duplicate content voor zoekmachines oplosten, bepalen ze nu óók welke paginaversie AI-engines als bronmateriaal gebruiken.
Stel: uw webshop heeft productpagina's die via meerdere URL's bereikbaar zijn. Zonder correct geïmplementeerde canonicals interpreteren AI-crawlers elke variant als een aparte bron. Het resultaat? Uw autoriteit wordt gefragmenteerd over tientallen URL's, en AI-engines citeren uw concurrent in plaats van u.
De verschuiving van traditionele SEO naar Generative Engine Optimization (GEO) maakt technische hygiëne urgenter dan ooit. Canonical tags vormen daarin een cruciale eerste verdedigingslinie.
Hoe AI-crawlers canonical tags interpreteren
AI-crawlers werken fundamenteel anders dan de Googlebot. Traditionele crawlers volgen het canonicalsignaal om te bepalen welke pagina in de zoekresultaten verschijnt. AI-crawlers gebruiken dezelfde signalen om te beslissen welke content zij als citeerbare bron opslaan in hun trainingsdata of retrieval-systemen.
Dit verschil heeft drie directe consequenties:
- Fragmentatie van autoriteit. Als GPTBot of ClaudeBot meerdere URL-varianten indexeert, wordt uw domeinautoriteit verspreid. Eén sterke canonical voorkomt dit.
- Inconsistente antwoorden. AI-engines kunnen tegenstrijdige informatie uit verschillende paginaversies halen. Dit schaadt uw merkreputatie in AI-gegenereerde antwoorden.
- Verspilde crawlbudget. AI-crawlers hebben een beperkt crawlbudget per domein. Elke duplicate URL die zij bezoeken gaat ten koste van pagina's die wél geciteerd moeten worden.
De technische setup van uw site bepaalt dus direct uw AI-zichtbaarheid. Zonder correcte canonicals verliest u grip op hoe AI over uw merk rapporteert.
De vier meest voorkomende canonical-fouten bij AI-crawlers
In de praktijk zien we dezelfde implementatiefouten steeds terugkomen. Hieronder de vier die de grootste impact hebben op uw GEO Readiness Score.
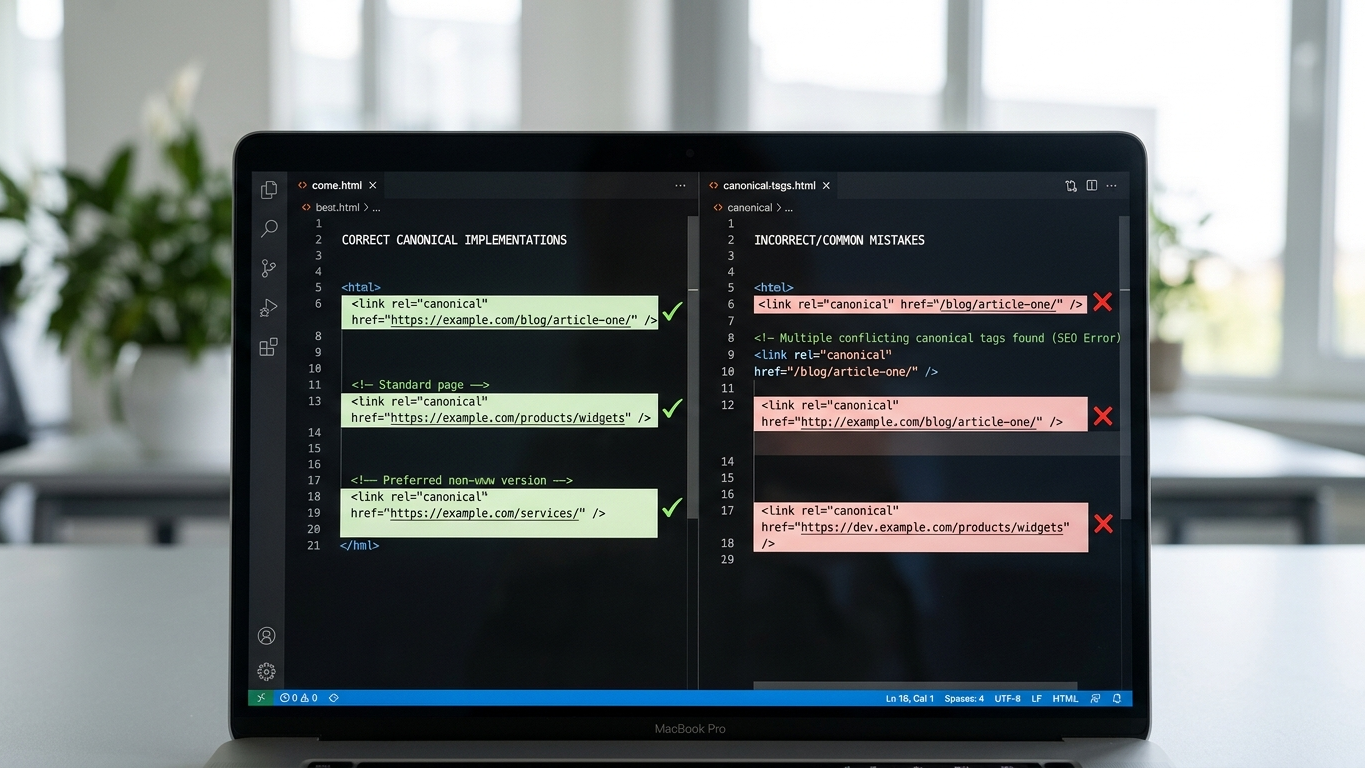
1. Self-referencing canonicals ontbreken
Elke pagina moet een canonical tag bevatten die naar zichzelf verwijst. Zonder dit signaal beschouwen AI-crawlers de pagina als potentieel duplicate content. Implementeer op elke pagina:
<link rel="canonical" href="https://uwdomein.nl/pagina/" />2. Canonical wijst naar een niet-indexeerbare pagina
Een canonical die verwijst naar een pagina met een noindex-tag of een pagina die geblokkeerd is in uw robots.txt, creëert een conflicterend signaal. AI-crawlers negeren in dat geval beide instructies. Valideer altijd dat de canonical-URL daadwerkelijk toegankelijk en indexeerbaar is.
3. HTTP- en HTTPS-varianten door elkaar
Als uw canonical naar de HTTP-versie verwijst terwijl uw site op HTTPS draait, interpreteren AI-crawlers dit als twee afzonderlijke bronnen. Zorg dat canonical tags consequent het HTTPS-protocol gebruiken.
4. Parameters in canonical-URL's
URL's met sessie-ID's, tracking-parameters of filteropties moeten altijd een canonical hebben die naar de schone URL verwijst. AI-crawlers zijn bijzonder gevoelig voor parametervervuiling.
| Fout | Impact op AI-zichtbaarheid | Prioriteit |
|---|---|---|
| Ontbrekende self-referencing canonical | Fragmentatie van domeinautoriteit | Kritiek |
| Canonical naar noindex-pagina | Volledige uitsluiting uit AI-bronnen | Kritiek |
| HTTP/HTTPS mismatch | Dubbele indexering door AI-crawlers | Hoog |
| Parameters in canonical-URL | Vervuiling van crawlbudget | Middel |
Canonical tags in combinatie met llms.txt en robots.txt
Canonical tags, llms.txt en robots.txt moeten op elkaar afgestemd zijn om inconsistenties en tegenstrijdige signalen aan AI-crawlers te voorkomen.
Canonical tags functioneren niet in isolatie. Ze vormen onderdeel van een breder technisch framework dat bepaalt of en hoe AI-crawlers uw content verwerken.
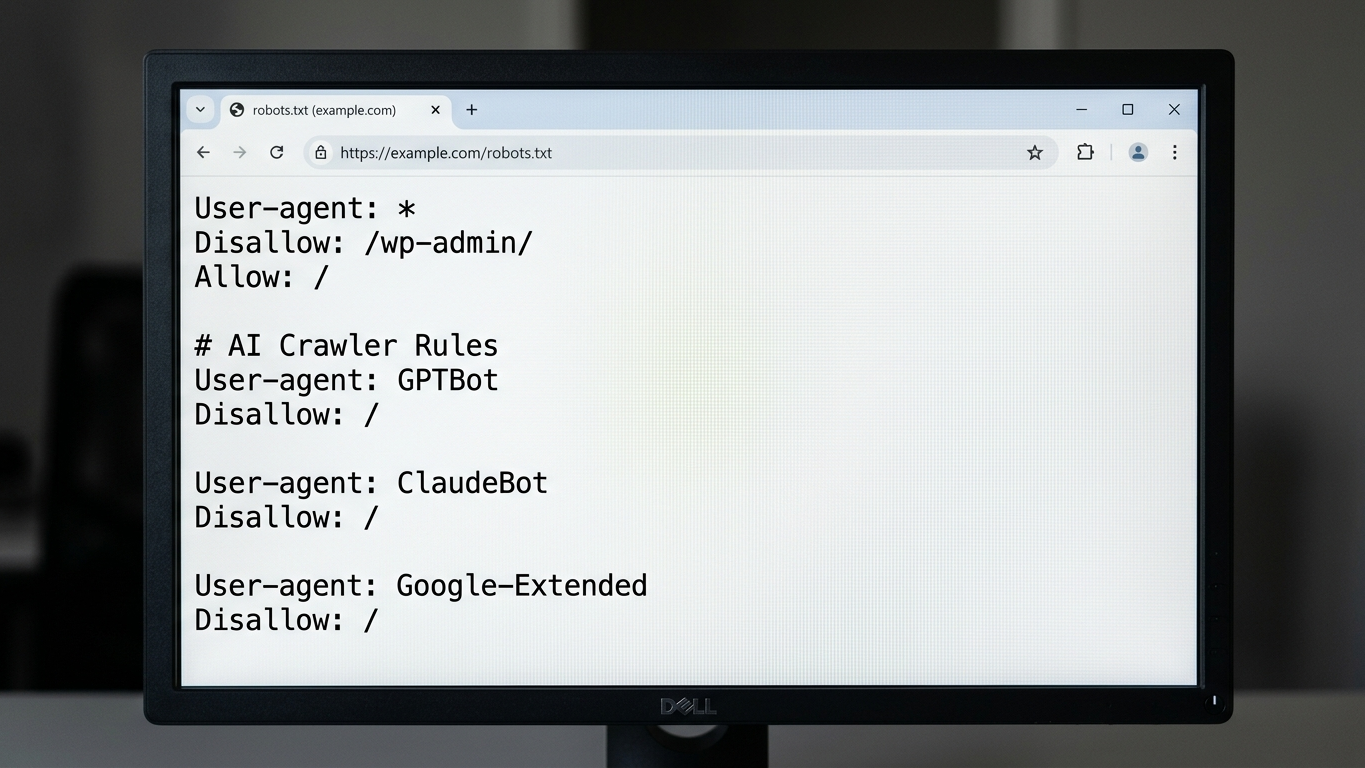
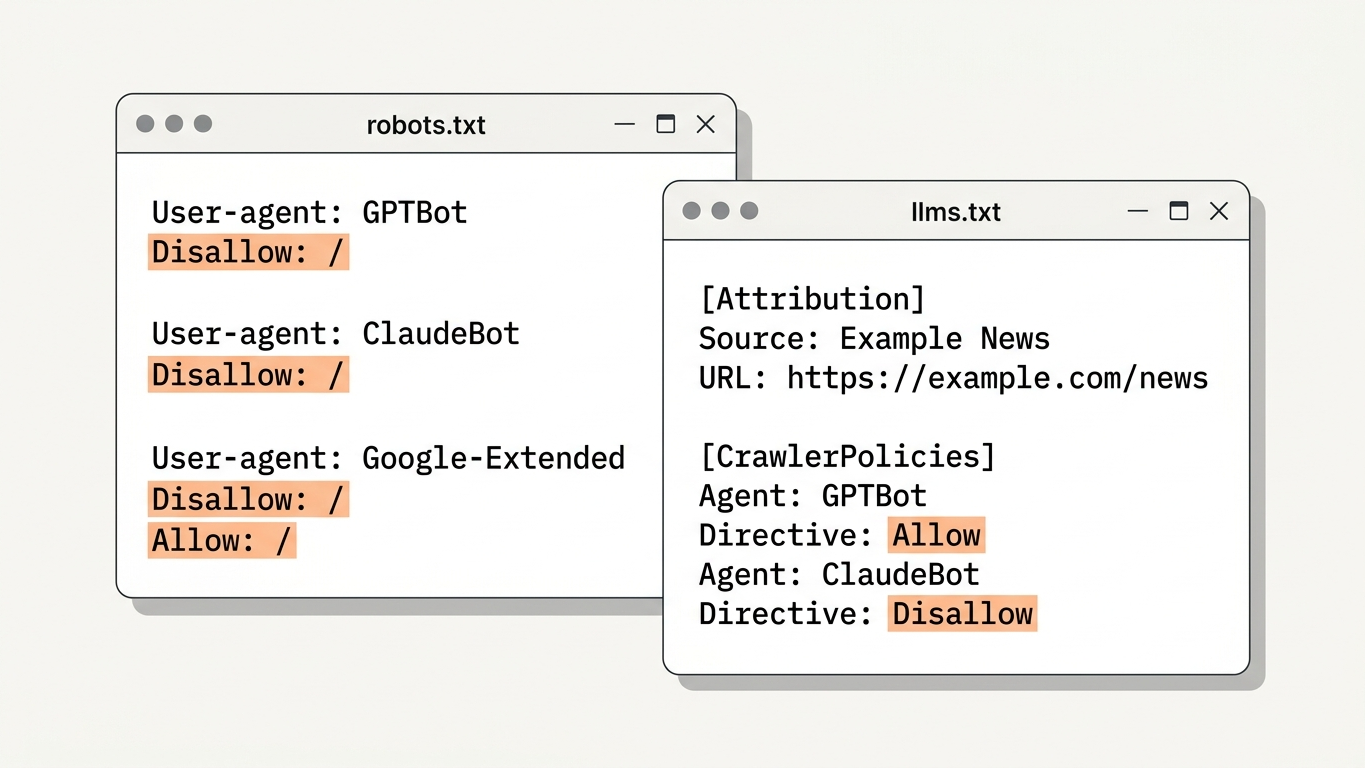
Uw llms.txt-bestand vertelt AI-engines welke pagina's zij mogen raadplegen als primaire bron. Uw robots.txt bepaalt welke crawlers überhaupt toegang hebben. Canonical tags geven vervolgens aan welke URL-versie de voorkeur heeft.
Deze drie elementen moeten op elkaar afgestemd zijn:
- Pagina's die u in llms.txt opneemt, moeten een correcte canonical hebben.
- Pagina's die u in robots.txt blokkeert voor AI-crawlers, mogen niet als canonical-doel dienen.
- De canonical-URL moet overeenkomen met de URL die u in uw llms.txt vermeldt.
Inconsistenties tussen deze bestanden zorgen ervoor dat AI-crawlers tegenstrijdige signalen ontvangen. Het gevolg is dat zij uw content volledig negeren.
Zo valideert u uw canonical-implementatie voor AI
Een handmatige controle van canonical tags op honderden pagina's is niet schaalbaar. U heeft geautomatiseerde validatie nodig die specifiek controleert hoe AI-crawlers uw site interpreteren.
De stappen voor een effectieve validatie:
- Crawl uw site vanuit het perspectief van een AI-bot. Controleer of canonical tags correct worden gerenderd na JavaScript-executie. Veel frameworks laden canonical tags dynamisch, wat problemen veroorzaakt voor AI-crawlers die beperkte rendering-capaciteit hebben.
- Vergelijk uw canonical-URL's met uw llms.txt en robots.txt. Zoek naar conflicten en inconsistenties.
- Monitor uw GEO Readiness Score. Dit geeft u een kwantitatief beeld van hoe goed uw technische setup scoort op platforms als ChatGPT, Perplexity, Google AI Overviews en Claude.
Met een GrowthScope audit kunt u deze validatie direct uitvoeren. Zonder account, zonder API-keys, zonder setup. Vul uw domein in en ontvang binnen 10 minuten een rapport dat precies aangeeft waar uw canonical-implementatie tekortschiet.
Actieplan: canonical tags als onderdeel van uw technische GEO-sprint
Integreer canonical-validatie als vaste check in uw development-workflow. Dit is geen eenmalige exercitie, maar een doorlopend onderdeel van uw technische kwaliteitsborging.
Concrete stappen om vandaag te starten:
- Voer een Quickscan uit om uw huidige technische GEO-status te meten.
- Neem canonical-validatie op als Technical Health KPI in uw maandelijkse sprints.
- Stem uw canonical tags af op uw llms.txt en robots.txt configuratie.
- Plan kwartaalmatige trendtracking om te monitoren of AI-crawlers uw gewenste paginaversies daadwerkelijk als bron gebruiken.
Uw technische infrastructuur bepaalt of AI-engines uw merk noemen of negeren. Canonical tags zijn daarin geen detail. Ze zijn de basis. Start vandaag uw audit en ontdek binnen minuten waar uw kansen liggen.